레이블이 Hadoop인 게시물을 표시합니다. 모든 게시물 표시

2018년 5월 14일 월요일

Apache Spark 2.0 개요


목차

  • Apache Hadoop
    • Hadoop 구성
  • Apache Spark
    • Spark란?
    • 데이터구조
    • 클러스터 구성
    • 에코 시스템
    • Apache Zeppelin
  • 설치
    • Apache Spark
    • Apache Zeppelin


Apache Hadoop

●     Hadoop 구성
○     HDFS (Hadoop Distributed File System)
: 파일을 클러스터에 분산해서 저장하고 관리하는 분산 파일 시스템


○     MapReduce
: 대용량 데이터 처리를 분산 병렬 컴퓨팅 환경에서 처리하기 위한 소프트웨어 프레임워크. 함수형 프로그래밍에서 일반적으로 사용되는 Map과 Reduce 함수를 기반으로 주로 구성된다.

○     YARN (Yet Another Resource Negotiator)
: 클러스터의 리소스 관리, 장애 관리 등을 담당하는 프레임워크

Apache Spark

●     Spark란? (2018.04 현재 2.3.0 버전)
○     오픈 소스 클러스터 컴퓨팅 프레임워크
○     Hadoop 보다 100배 가량 빠르다.
■     Hadoop 처리 방식
■     장애복구 (Fault tolerance)를 위해서 비효율적이지만 디스크에 복구지점을 저장하면서 수행한다.
■     Spark 처리 방식
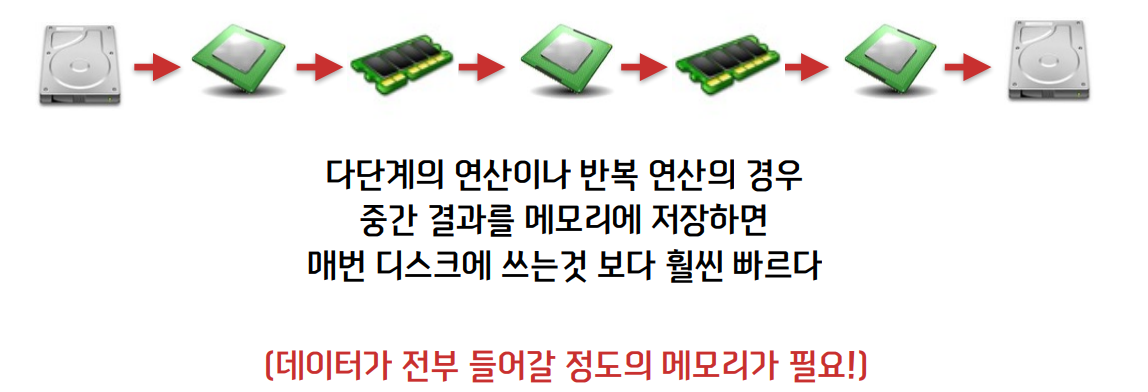
■     장애 복구는 RDD라는 데이터 구조와 DAG (Directed Acyclic Graph)를 이용한 Lineage(계보)를 이용해서 가능하다. 그래도 어쨌든 장애가 발생하면 처음부터 다시 시작해야 되긴하다.
●     데이터 구조
○     RDD (Resilient Distributed Datasets) - Spark 1.0
■     데이터를 가지고 있으며, Scala collection으로 나타냄
■     장애 발생 시 복구 가능
■     Partition이라 불리는 작은 단위로 나눠서 사용 가능
■     Partition을 single machine에서 처리하지 않고, cluster에 분배해서 처리
■     한번 정의하면 변경 불가능. 읽기 전용 데이터 구조
■     RDD 생성 방식
●     데이터 소스로부터 불러옴
●     다른 RDD를 변형해서 새로운 RDD를 만드는 것
■     RDD 연산 : Lazy
●     Transformation : 행위를 기록할 뿐 연산작업이 실제 이루어 지지 않음
○     명령어 : map,  join, filter, sort 등...
●     Action : 모든 작업을 최적화된 경로로 수행 (컴파일러와 비슷)
○     명령어 : count, collect, reduce, save 등...
■     DAG 형태로 Transformation의 Lineage(계보)를 만들고, 중간 과정 데이터는 전부 저장하지 않음
■     장애 발생 시 Lineage를 통해서 처음부터 다시 계산 (게임 비유 -> 세이브 VS 공략집)
○     DataFrame - Spark 1.3
■     명시적인 타입이 지정이 안되어 있는 데이터 구조
■     org.apache.spark.sql.Row 타입의 데이터로 구성된 데이터 셋
■     개념적으로는 RDB의 테이블과 같다.
○     DataSet - Spark 1.6
■     정형 데이터, 반정형 데이터를 처리할 때 사용하는 데이터 구조
■     lambda 함수 사용 가능
■     사용 권장. 성능면에서도 우위에 있다.
○     DataFrame, DataSet 통합 - Spark 2.0    
■     Typed API : DataSet[T]
■     Untyped API : DataFrame = DataSet[Row]
○     비교
■     DataFrame, DataSet 모두 내부적으로는 RDD를 사용한다.


●     클러스터 구성
○     Driver Program
: 프로그램의 Main 함수 (시작점)
■     SparkContext
: 어떻게 클러스터에 접근할 수 있는지 알려주는 객체 (SparkConf 필요)
○     Cluster Manager
: 클러스터에서 필요한 자원을 찾아줌
○     Worker Node
: 실제 작업을 수행하는 노드
■     Executor
: Task를 수행하는 Process
■     Task
: Executor에 할당되는 작업의 단위
■     Job
: 사용자 입장에서의 작업의 단위 (Task의 조합)
●     에코 시스템 : 데이터 분석을 위한 종합 선물 세트
○     분산 저장소 (Distributed Storage)
■     Local FS
■     HDFS (Hadoop Distributed File System)
■     S3
■     CFS (Cassandra File System)
○     클러스터 리소스 매니저 (Cluster Resource Manager)
■     Standalone
■     Hadoop YARN
■     Apache Mesos
○     Spark Core API
■     다양한 언어 지원 : Scala (추천), Python, Java, R
■     쉽고 편리한 인터페이스
○     Spark SQL (SQL Queries) ↔ Apache Hive
○     Spark Streaming (Stream Processing) ↔ Apache Storm
○     MLlib (Machine Learning) ↔ Apache Mahout
○     GraphX (Graph Processing) ↔ Apache Giraph
●     Apache Zeppelin
○     Zeppelin이란?
■     클러스터 구성 없이 간단하게 Spark를 실행할 수 있는 환경
■     Jupyter Notebook과 비슷
■     인터랙티브하게 실행할 수 있다.
■     Spark SQL 실행 결과를 바로 시각화 할 수 있다.

설치

Apache Spark 설치

●     사전 조건
○     Ubuntu 14.X 이상
○     JAVA 1.7 버전 이상 설치, JAVA_HOME 환경변수 등록
●     바이너리 다운로드
○     https://spark.apache.org/downloads.html 에서 원하는 버전 선택해서 다운로드
○     Apache Zeppelin이 지원하는 최신 버전이 2.2.0이므로 그 버전 다운로드
●     압축 해제 (/home/ubuntu 가 홈이라고 가정)
○     tar zxvf spark-2.2.0-bin-hadoop2.7.tgz
●     소프트링크 생성
○     ln -s spark-2.2.0-bin-hadoop2.7 spark
●     환경변수 등록
○     vi ~/.bashrc
아래 내용 추가
export SPARK_HOME=/home/ubuntu/spark
export PATH=$PATH:$SPARK_HOME/bin

Apache Zeppelin 설치

●     바이너리 다운로드
○     http://zeppelin.apache.org/download.html 에서 원하는 버전 선택해서 다운로드
○     잘 모르겠으면 그냥 모든 인터프리터 다 포함되어 있는 버전 다운로드 zeppelin-0.7.3-bin-all.tgz
○     2018.04.25 현재 0.7.3 이 최신 버전이며, Spark 2.2.0을 지원
○     wget http://mirror.navercorp.com/apache/zeppelin/zeppelin-0.7.3/zeppelin-0.7.3-bin-all.tgz
●     압축 해제
○     tar zxvf zeppelin-0.7.3-bin-all.tgz
●     소프트링크 생성
○     ln -s zeppelin-0.7.3-bin-all zeppelin
●     환경변수 등록
○     vi ~/.bashrc
아래 내용 추가
export ZEPPELIN_HOME=/home/ubuntu/zeppelin
export PATH=$PATH:$ZEPPELIN_HOME/bin
●     SPARK_HOME 설정
○     zeppelin 설정 디렉터리로 이동
cd ZEPPELIN_HOME/conf
○     템플릿 파일 복사
cp zeppelin-env.sh.template zeppelin-env.sh
○     템플릿 수정
vi zeppelin-env.sh
○     SPARK_HOME 설정
SPARK_HOME=/home/ubuntu/spark


예제


참고 자료

2017년 11월 2일 목요일

html 파일 읽어서 파싱 후 원하는 데이터만 파일로 출력하는 MapReduce 프로그램

참고

HTML 파싱
https://github.com/shsdev/hocr-parser-hadoopjob/blob/master/src/main/java/eu/scape_project/tb/lsdr/hocrparser/HocrParser.java

Jsoup
http://partnerjun.tistory.com/42

Hadoop InputFormat
하둡 완벽 가이드 4판 - 파일의 전체 내용을 하나의 레코드로 처리하기
https://github.com/tomwhite/hadoop-book/blob/master/ch08-mr-types/src/main/java/WholeFileInputFormat.java

동기

하둡을 이용해서 네이버 블로그(모바일 버전)를 다운 받아서 해당 페이지에서 필요한 내용을 파싱하고 싶었다. 그래서 맵리듀스로 html 파싱이 가능한지 찾아봤는데, 아주 조금의 예제들이 나왔다. 그런데 map 함수에서 뭔가를 다 처리하고 있어서 이쁘게 보이지 않아서 custom InputFormat을 만들어서 사용하는 법을 알아봤다. 다행히 하둡 완벽 가이드에 적절한 예제가 있어서 두 가지를 조합에서 간단한 예제 프로그램을 만들었다.

준비물

모바일 네이버 블로그 게시물 html 파일
http://m.blog.naver.com/Recommendation.nhn 에 들어가서 맘에 드는 게시물의 URL을 복사한다. 복사한 URL로 그대로 wget으로 받으려 하면 엉뚱한 페이지가 다운 받아 진다. 그래서 URL은 https://m.blog.naver.com/PostView.nhn?blogId=xxxx&logNo=xxxx 를 치고 들어가면 나오는 https://m.blog.naver.com/id/post_no 를 wget으로 다운 받으면 된다.
적당히 5 ~ 6 개 정도 다운 받아서 디렉터리 통째로 HDFS에 올린다.

프로그램 작성

pom.xml
<dependencies>

        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-client</artifactId>
            <version>2.7.3</version>
        </dependency>

        <dependency>
            <groupId>org.jsoup</groupId>
            <artifactId>jsoup</artifactId>
            <version>1.10.3</version>
        </dependency>

    </dependencies>

    <build>
        <plugins>
            <plugin>
                <artifactId>maven-assembly-plugin</artifactId>
                <version>3.1.0</version>
                <configuration>
                    <descriptorRefs>
                        <descriptorRef>
                            jar-with-dependencies
                        </descriptorRef>
                    </descriptorRefs>
                </configuration>
                <executions>
                    <execution>
                        <id>make-assembly</id> <!-- this is used for inheritance merges -->
                        <phase>package</phase> <!-- bind to the packaging phase -->
                        <goals>
                            <goal>single</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>

HtmlFileInputFormat.java
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.BytesWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.InputSplit;
import org.apache.hadoop.mapreduce.JobContext;
import org.apache.hadoop.mapreduce.RecordReader;
import org.apache.hadoop.mapreduce.TaskAttemptContext;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import java.io.IOException;

/**
 * HTML 파일을 통째로 읽는 FileInputFormat
 */
public class HtmlFileInputFormat extends FileInputFormat<NullWritable, Text> {

    /* 파일을 통째로 읽어야 되기 때문에 split 되지 않게 함 */
    protected boolean isSplitable(JobContext context, Path file) {
        return false;
    }

    public RecordReader<NullWritable, Text> createRecordReader(InputSplit split, TaskAttemptContext context) throws IOException, InterruptedException {
        HtmlFileRecordReader reader = new HtmlFileRecordReader();
        reader.initialize(split, context);
        return reader;
    }
}

HtmlFileRecordReader.java
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataInputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IOUtils;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.InputSplit;
import org.apache.hadoop.mapreduce.RecordReader;
import org.apache.hadoop.mapreduce.TaskAttemptContext;
import org.apache.hadoop.mapreduce.lib.input.FileSplit;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;

import java.io.ByteArrayInputStream;
import java.io.IOException;
import java.io.InputStream;

public class HtmlFileRecordReader extends RecordReader <NullWritable, Text> {

    private FileSplit fileSplit;
    private Configuration conf;
    private Text value = new Text();
    private boolean processed = false;

    public void initialize(InputSplit split, TaskAttemptContext context) throws IOException, InterruptedException {
        this.fileSplit = (FileSplit) split;
        this.conf = context.getConfiguration();
    }

    public boolean nextKeyValue() throws IOException, InterruptedException {
        if(!processed) {
            byte [] contents = new byte[(int) fileSplit.getLength()];
            Path file =  fileSplit.getPath();
            FileSystem fs = file.getFileSystem(conf);
            FSDataInputStream in = null;
            try {
                in = fs.open(file);
                IOUtils.readFully(in, contents, 0, contents.length);
                InputStream inputStream = new ByteArrayInputStream(contents);
                Document doc = Jsoup.parse(inputStream, "UTF-8", "http://home.yoursite.com");
                value.set(doc.html());
            } finally {
                IOUtils.closeStream(in);
            }
            processed = true;
            return true;
        }
        return false;
    }

    public NullWritable getCurrentKey() throws IOException, InterruptedException {
        return NullWritable.get();
    }

    public Text getCurrentValue() throws IOException, InterruptedException {
        return value;
    }

    public float getProgress() throws IOException, InterruptedException {
        return processed ? 1.0f : 0.0f;
    }

    public void close() throws IOException {

    }
}

JobBuilder.java
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import org.apache.hadoop.util.GenericOptionsParser;
import org.apache.hadoop.util.Tool;

import java.io.IOException;

/**
 * Hadoop Job 생성
 * 1. 파라미터 개수 체크
 * 2. 설정, Job 이름 받아서 Job 생성
 * 3. 입/출력 데이터 위치 지정
 * 4. 출력 위치에 데이터가 있으면 삭제
 */
public class JobBuilder {
    public static Job parseInputAndOutput(Tool tool, Configuration conf, String[] args, String jobName) throws IOException {

        /* 파라미터 개수 체크 */
        if (args.length != 2) {
            printUsage(tool, "<input> <output>");
            return null;
        }

        /* 설정, Job 이름 받아서 Job 생성 */
        Job job = Job.getInstance(conf, jobName);
        job.setJarByClass(tool.getClass());

        /* 입/출력 데이터 위치 지정 */
        Path inputPath = new Path(args[0]);
        Path outputPath = new Path(args[1]);
        FileInputFormat.addInputPath(job, inputPath);
        FileOutputFormat.setOutputPath(job, outputPath);

        /* 출력 위치에 데이터가 있으면 삭제 */
        outputPath.getFileSystem(conf).delete(outputPath,true);

        return job;
    }

    /* 사용법 출력 */
    public static void printUsage(Tool tool, String extraArgsUsage) {
        System.err.printf("Usage: %s [genericOptions] %s\n\n", tool.getClass().getSimpleName(), extraArgsUsage);
        GenericOptionsParser.printGenericCommandUsage(System.err);
    }
}


HtmlParserJob.java
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

/**
 * HTML 파일을 읽어서 DOM 파싱 하는 Hadoop Job
 */
public class HtmlParserJob extends Configured implements Tool {

    public int run(String[] args) throws Exception {

        /* 설정 가져와서 Job 생성 */
        Configuration conf = getConf();
        String jobName = new String("htmlparser");
        Job job = JobBuilder.parseInputAndOutput(this, conf, args, jobName);
        if (job == null) {
            return -1;
        }

        /* 입출력 포맷 클래스 지정 */
        job.setInputFormatClass(HtmlFileInputFormat.class);
        job.setOutputFormatClass(TextOutputFormat.class);

        /* 출력 Key/Value 클래스 지정 */
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(Text.class);

        /* Mapper / Reducer 클래스 지정 */
        job.setMapperClass(HtmlParserMapper.class);

        return job.waitForCompletion(true) ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        int res = ToolRunner.run(new Configuration(), new HtmlParserJob(), args);
        System.exit(res);
    }

}


HtmlParserMapper.java
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;

import java.io.IOException;

/**
 * HTML 파일 받아서 DOM을 파싱해서 원하는 데이터를 뽑아 내는 Mapper
 * http://m.blog.naver.com/id/post_no 의 데이터를 받아와서 파싱
 * Input Key (NullWritable) : 없음
 * Input Value (Text) : HTML 파일 전체
 * Output Key (Text) : 블로그 URL
 * Output Value (Text) : 태그 리스트 (태그 태그 태그 ...)
 */
public class HtmlParserMapper extends Mapper<NullWritable, Text, Text, Text> {

    @Override
    protected void map(NullWritable key, Text value, Context context) throws IOException, InterruptedException {

        /* Jsoup 문서 생성 */
        Document doc = Jsoup.parse(value.toString());

        /**
         * 블로그 URL 파싱
         * <meta property="og:url" content="http://blog.naver.com/id/post_no">
         * 형태의 데이터에서 content의 데이터를 파싱해 온다.
         */
        Element ogUrl = doc.select("meta[property=og:url]").first();
        String ogUrlContent = ogUrl.attr("content");
        Text textKey = new Text(ogUrlContent);

        /**
         * 태그 파싱
         * <div class="post_tag">
         *     <ul>
         *         <li>
         *             <a>
         *                 <span>태그</span>
         *                 <span>태그</span>
         *                 <span>태그</span>
         *             </a>
         *         </li>
         *     </ul>
         * </div>
         * span 태그 사이의 텍스트 파싱
         */
        Elements postTags = doc.getElementsByClass("post_tag").first().select("span");

        String postTagValues = new String();

        /* span 리스트를 돌면서 텍스트를 뽑아내서 문자열로 이어 붙임 */
        for(Element postTag : postTags) {
            postTagValues += postTag.ownText() + " ";
        }

        Text textValue = new Text(postTagValues);

        context.write(textKey, textValue);
    }

}

결과물
http://blog.naver.com/xxxxxx/xxxxxx      #태그1
http://blog.naver.com/xxxxxx/xxxxxx      #태그1 #태그2 #태그3 #태그4 #태그5
http://blog.naver.com/xxxxxx/xxxxxx   #태그1 #태그2
http://blog.naver.com/xxxxxx/xxxxxx      #태그1
http://blog.naver.com/xxxxxx/xxxxxx     #태그1 #태그2 #태그3
http://blog.naver.com/xxxxxx/xxxxxx     #태그1

이런식으로 블로그 URL과 태그 목록이 나온다.