목차
- Apache Hadoop
- Hadoop 구성
- Apache Spark
- Spark란?
- 데이터구조
- 클러스터 구성
- 에코 시스템
- Apache Zeppelin
- 설치
- Apache Spark
- Apache Zeppelin
Apache Hadoop
● Hadoop 구성
○ HDFS (Hadoop Distributed File System)
: 파일을 클러스터에 분산해서 저장하고 관리하는 분산 파일 시스템
: 파일을 클러스터에 분산해서 저장하고 관리하는 분산 파일 시스템

○ MapReduce
: 대용량 데이터 처리를 분산 병렬 컴퓨팅 환경에서 처리하기 위한 소프트웨어 프레임워크. 함수형 프로그래밍에서 일반적으로 사용되는 Map과 Reduce 함수를 기반으로 주로 구성된다.
: 대용량 데이터 처리를 분산 병렬 컴퓨팅 환경에서 처리하기 위한 소프트웨어 프레임워크. 함수형 프로그래밍에서 일반적으로 사용되는 Map과 Reduce 함수를 기반으로 주로 구성된다.

○ YARN (Yet Another Resource Negotiator)
: 클러스터의 리소스 관리, 장애 관리 등을 담당하는 프레임워크
: 클러스터의 리소스 관리, 장애 관리 등을 담당하는 프레임워크

Apache Spark
● Spark란? (2018.04 현재 2.3.0 버전)
○ 오픈 소스 클러스터 컴퓨팅 프레임워크
○ Hadoop 보다 100배 가량 빠르다.
■ Hadoop 처리 방식

■ 장애복구 (Fault tolerance)를 위해서 비효율적이지만 디스크에
복구지점을 저장하면서 수행한다.
■ Spark 처리 방식
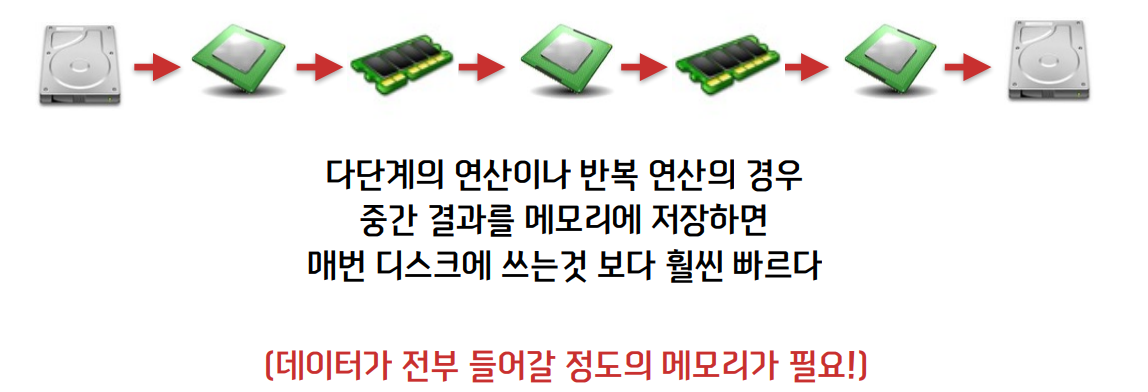
■ 장애 복구는 RDD라는 데이터 구조와 DAG (Directed
Acyclic Graph)를 이용한 Lineage(계보)를 이용해서 가능하다. 그래도 어쨌든 장애가 발생하면 처음부터 다시 시작해야 되긴하다.
●
데이터
구조
○
RDD (Resilient Distributed
Datasets) - Spark 1.0
■ 데이터를 가지고 있으며, Scala collection으로 나타냄
■ 장애 발생 시 복구 가능
■ Partition이라 불리는 작은 단위로 나눠서 사용 가능
■ Partition을 single machine에서 처리하지 않고,
cluster에 분배해서 처리
■ 한번 정의하면 변경 불가능. 읽기 전용 데이터 구조
■ RDD 생성 방식
● 데이터 소스로부터 불러옴
● 다른 RDD를 변형해서 새로운 RDD를 만드는 것
■ RDD 연산 : Lazy

● Transformation : 행위를 기록할 뿐 연산작업이 실제 이루어 지지
않음
○ 명령어 : map, join, filter, sort 등...
● Action : 모든 작업을 최적화된 경로로 수행 (컴파일러와 비슷)
○ 명령어 : count, collect, reduce, save 등...
■ DAG 형태로 Transformation의 Lineage(계보)를 만들고,
중간 과정 데이터는 전부 저장하지 않음
■ 장애 발생 시 Lineage를 통해서 처음부터 다시 계산 (게임 비유
-> 세이브 VS 공략집)

○ DataFrame
- Spark 1.3
■ 명시적인 타입이 지정이 안되어 있는 데이터 구조
■ org.apache.spark.sql.Row 타입의 데이터로 구성된 데이터
셋
■ 개념적으로는 RDB의 테이블과 같다.
○ DataSet
- Spark 1.6
■ 정형 데이터, 반정형 데이터를 처리할 때 사용하는 데이터 구조
■ lambda 함수 사용 가능
■ 사용 권장. 성능면에서도 우위에 있다.
○ DataFrame, DataSet 통합 - Spark 2.0
■ Typed
API : DataSet[T]
■
Untyped API : DataFrame =
DataSet[Row]
○ 비교

■ DataFrame, DataSet 모두 내부적으로는 RDD를 사용한다.


● 클러스터 구성

○ Driver Program
: 프로그램의 Main 함수 (시작점)
: 프로그램의 Main 함수 (시작점)
■ SparkContext
: 어떻게 클러스터에 접근할 수 있는지 알려주는 객체 (SparkConf 필요)
: 어떻게 클러스터에 접근할 수 있는지 알려주는 객체 (SparkConf 필요)
○ Cluster Manager
: 클러스터에서 필요한 자원을 찾아줌
: 클러스터에서 필요한 자원을 찾아줌
○ Worker Node
: 실제 작업을 수행하는 노드
: 실제 작업을 수행하는 노드
■ Executor
: Task를 수행하는 Process
: Task를 수행하는 Process
■ Task
: Executor에 할당되는 작업의 단위
: Executor에 할당되는 작업의 단위
■ Job
: 사용자 입장에서의 작업의 단위 (Task의 조합)
: 사용자 입장에서의 작업의 단위 (Task의 조합)
● 에코 시스템 : 데이터 분석을 위한 종합 선물 세트

○ 분산 저장소 (Distributed Storage)
■ Local
FS
■
HDFS (Hadoop Distributed
File System)
■ S3
■ CFS
(Cassandra File System)
○ 클러스터 리소스 매니저 (Cluster Resource Manager)
■ Standalone
■ Hadoop
YARN
■ Apache
Mesos
○ Spark
Core API
■ 다양한 언어 지원 : Scala (추천), Python, Java, R
■ 쉽고 편리한 인터페이스

○
Spark SQL (SQL Queries) ↔ Apache Hive
○
Spark Streaming (Stream Processing) ↔ Apache Storm
○
MLlib (Machine Learning) ↔ Apache Mahout
○
GraphX (Graph Processing) ↔ Apache Giraph
● Apache
Zeppelin
○ Zeppelin이란?
■ 클러스터 구성 없이 간단하게 Spark를 실행할 수 있는 환경
■ Jupyter Notebook과 비슷
■ 인터랙티브하게 실행할 수 있다.
■ Spark SQL 실행 결과를 바로 시각화 할 수 있다.
설치
Apache Spark 설치
● 사전 조건
○ Ubuntu 14.X 이상
○ JAVA 1.7 버전 이상 설치, JAVA_HOME 환경변수 등록
● 바이너리 다운로드
○ https://spark.apache.org/downloads.html 에서 원하는 버전 선택해서 다운로드
○ Apache Zeppelin이 지원하는 최신 버전이 2.2.0이므로 그 버전
다운로드
● 압축 해제 (/home/ubuntu 가 홈이라고 가정)
○
tar zxvf
spark-2.2.0-bin-hadoop2.7.tgz
● 소프트링크 생성
○
ln -s
spark-2.2.0-bin-hadoop2.7 spark
● 환경변수 등록
○ vi ~/.bashrc
아래 내용 추가
export SPARK_HOME=/home/ubuntu/spark
export PATH=$PATH:$SPARK_HOME/bin
아래 내용 추가
export SPARK_HOME=/home/ubuntu/spark
export PATH=$PATH:$SPARK_HOME/bin
Apache Zeppelin 설치
● 바이너리 다운로드
○ http://zeppelin.apache.org/download.html 에서 원하는 버전 선택해서 다운로드
○ 잘 모르겠으면 그냥 모든 인터프리터 다 포함되어 있는 버전 다운로드
zeppelin-0.7.3-bin-all.tgz
○ 2018.04.25 현재 0.7.3 이 최신 버전이며, Spark
2.2.0을 지원
○
wget
http://mirror.navercorp.com/apache/zeppelin/zeppelin-0.7.3/zeppelin-0.7.3-bin-all.tgz
● 압축 해제
○
tar zxvf
zeppelin-0.7.3-bin-all.tgz
● 소프트링크 생성
○
ln -s
zeppelin-0.7.3-bin-all zeppelin
● 환경변수 등록
○ vi ~/.bashrc
아래 내용 추가
아래 내용 추가
export ZEPPELIN_HOME=/home/ubuntu/zeppelin
export PATH=$PATH:$ZEPPELIN_HOME/bin
● SPARK_HOME 설정
○ zeppelin 설정 디렉터리로 이동
cd ZEPPELIN_HOME/conf
cd ZEPPELIN_HOME/conf
○ 템플릿 파일 복사
cp zeppelin-env.sh.template zeppelin-env.sh
cp zeppelin-env.sh.template zeppelin-env.sh
○ 템플릿 수정
vi zeppelin-env.sh
vi zeppelin-env.sh
○ SPARK_HOME 설정
SPARK_HOME=/home/ubuntu/spark
SPARK_HOME=/home/ubuntu/spark


