2018년 5월 18일 금요일

Elastic Stack을 이용한 서버 에러 로그 대시보드 만들기

각 서버에 분산되어 있는 에러 로그를 FileBeat를 통해서 LogStash로 보내고, 데이터를 필터링 한 후 ElasticSearch에 저장한다. 저장 된 데이터를 Kibana를 통해서 시각화하여 각 서버에서 발생하고 있는 에러 로그를 통합해서 볼 수 있게 한다.

시스템 구조


설치 환경


  • ElasticSearch, LogStash, Kibana를 로그 집계를 위한 한 서버에 설치
    • CPU : Intel(R) Xeon(R) CPU E5-2686 v4 @ 2.30GHz (듀얼코어)
    • RAM : 4GB
    • OS : Ubuntu 16.04 LTS
  • FileBeat를 로그가 발생하고 있는 각 서버에 설치
    • CPU : Intel(R) Xeon(R) CPU E5-2676 v3 @ 2.40GHz (싱글코어)
    • RAM : 1GB
    • OS : Ubuntu 14.04 LTS, 16.04 LTS

사전 준비


  • 자바 설치 (Java 8 이상 필요, Oracle JDK 1.8.0_131 버전 권장)
    sudo add-apt-repository ppa:webupd8team/java
    sudo apt-get update
    sudo apt-get install oracle-java8-installer
    sudo apt-get install oracle-java8-set-default 
  • 자바 버전 확인
    java -version

설치


  • ElasticSearch
    • 설치 패키지 다운로드
      wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.2.4.deb
    • 패키지 설치
      sudo dpkg -i elasticsearch-6.2.4.deb
    • 서비스(시스템 시작 시 자동 시작) 등록 / 해제
      sudo systemctl daemon-reload
      sudo systemctl enable elasticsearch.service
      sudo systemctl disable elasticsearch.service
    • 서비스 시작 / 종료
      sudo systemctl start elasticsearch.service
      sudo systemctl stop elasticsearch.service
    • 설치 확인
      curl -X GET "localhost:9200/"
      {
        "name" : "Cp8oag6",
        "cluster_name" : "elasticsearch",
        "cluster_uuid" : "AT69_T_DTp-1qgIJlatQqA",
        "version" : {
          "number" : "6.2.4",
          "build_hash" : "f27399d",
          "build_date" : "2016-03-30T09:51:41.449Z",
          "build_snapshot" : false,
          "lucene_version" : "7.2.1",
          "minimum_wire_compatibility_version" : "1.2.3",
          "minimum_index_compatibility_version" : "1.2.3"
        },
        "tagline" : "You Know, for Search"
      }
  • Kibana
    • 설치 패키지 다운로드
      wget https://artifacts.elastic.co/downloads/kibana/kibana-6.2.4-amd64.deb
    • 패키지 설치
      sudo dpkg -i kibana-6.2.4-amd64.deb
    • 서비스 등록
      sudo systemctl daemon-reload
      sudo systemctl enable kibana.service
    • 서비스 시작
      sudo systemctl start kibana.service
    • 설치 확인
      인터넷 브라우저에서 localhost:5601로 접속해서 kibana 화면이 나오는지 확인

  • LogStash
    • 설치 패키지 다운로드
      wget https://artifacts.elastic.co/downloads/logstash/logstash-6.2.4.deb
    • 패키지 설치
      sudo dpkg -i logstash-6.2.4.deb
    • 서비스 등록
      sudo systemctl daemon-reload
      sudo systemctl enable logstash.service
    • 서비스 시작
      sudo systemctl start logstash.service


  • FileBeat
    • 설치 패키지 다운로드
      wget https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-6.2.4-amd64.deb
    • 패키지 설치
      sudo dpkg -i filebeat-6.2.4-amd64.deb
    • 서비스 등록
      sudo systemctl daemon-reload
      sudo systemctl enable filebeat.service
    • 서비스 시작
      sudo systemctl start filebeat.service


환경 설정

  • ElasticSearch
    • 설정 파일 수정
      sudo vi /etc/elasticsearch/elasticsearch.yml
      - ElasticSearch와 binding 할 IP 주소를 설정한다. (port는 수정 안 할 경우 기본 9200)
      network.host : 0.0.0.0
    • 서비스 재시작
      sudo systemctl restart elasticsearch.service
  • Kibana
    • 설정 파일 수정
      sudo vi /etc/kibana/kibana.yml
      - Kibana와 binding할 IP 주소를 설정한다. (port는 수정 안 할 경우 기본 5601)
      server.host : "0.0.0.0"
      elasticsearch.url : "http://elasticsearch_server_address:9200"
    • 서비스 재시작
      sudo systemctl restart kibana.service

  • LogStash
    • 설정 파일 생성
      sudo vi /etc/logstash/conf.d/[원하는 파일 명].conf
      input {
        beats {
          port => 5044
        }
      }
      
      filter {
        if [fields][server_name] == "api-server" {
          if [fields][log_type] == "nginx_access" {
            grok {
              match => { "message" => ["%{IPORHOST:[nginx][access][remote_ip]} - %{DATA:[nginx][access][user_name]} \[%{HTTPDATE:[nginx][access][time]}\] \"%{WORD:[nginx][access][method]} %{DATA:[nginx][access][url]} HTTP/%{NUMBER:[nginx][access][http_version]}\" %{NUMBER:[nginx][access][response_code]} %{NUMBER:[nginx][access][body_sent][bytes]} \"%{DATA:[nginx][access][referrer]}\"\"%{DATA:[nginx][access][agent]}\""] }
              remove_field => "message"
            }
            mutate {
              add_field => { "read_timestamp" => "%{@timestamp}" }
            }
            date {
              match => [ "[nginx][access][time]", "dd/MMM/YYYY:H:m:s Z" ]
              remove_field => "[nginx][access][time]"
            }
            useragent {
              source => "[nginx][access][agent]"
              target => "[nginx][access][user_agent]"
              remove_field => "[nginx][access][agent]"
            }
            geoip {
              source => "[nginx][access][remote_ip]"
              target => "[nginx][access][geoip]"
            }
          }
        }
      }
      
      output {
        if([fields][server_name] == "api-server" and [fields][log_type] == "nginx_access") {
          elasticsearch {
            hosts => ["localhost:9200"]
            index => "new-api-access-log-%{+YYYY.MM.dd}"
          }
        }
        else {
          elasticsearch {
            hosts => ["localhost:9200"]
            index => "error-log-%{+YYYY.MM.dd}"
          }
        }
      }
      filebeat에서 로그 데이터를 받아서 nginx_access 로그만 별도의 index에 저장하고 나머지는 기본 index를 사용해서 elasticsearch에 저장 하는 설정

    • 서비스 재시작
      sudo systemctl restart logstash.service

  • FileBeat
    • 설정 파일 수정
      sudo vi /etc/filebeat/filebeat.yml
      filebeat.prospectors:
      - type : log
        enabled: true
        paths:
          - /var/log/php7.0-fpm.log
      
      
      - type : log
        enabled: true
        paths:
          - /var/log/nginx/error.log
        fields:
          server_name: api-server
          log_type: nginx_error
      
      #output.elasticsearch:
      
      output.logstash:
        hosts: ["logstash_server_address:5044"]
php-fpm, nginx에서 발생하는 에러 로그를 수집하기 위한 설정. 빨간색 부분은 추가 데이터를 지정하는 부분 kibana에서 server_name 별로 필터링해서 보여주고자 할 때 이런식으로 각 서버 마다 server_name을 다르게 설정하면, 원하는 서버만 필터링해서 보기 편하다. elasticsearch에 바로 데이터를 보내지 않고, logstash를 거치기 때문에 elasticsearch 설정은 주석 처리한다.

    • 모듈 사용 설정
      : 많이 사용하는 것들은 미리 module로 빼 놓았다. 지원 module 목록
      • nginx 모듈 사용 설정
        sudo filebeat modules enable nginx
      • 설정 된 모듈 확인
        sudo filebeat modules list
      • 초기 환경 설정
        sudo filebeat setup -e
      • 모듈 설정 파일 수정
        sudo vi /etc/filebeat/modules.d/nginx.yml
        - module: nginx
          # Access logs
          access:
            enabled: true
            prospector:
              fields:
                server_name: api-server
                log_type: nginx_access
    • 서비스 재시작
      sudo systemctl restart filebeat.service
  • Kibana
    • 접속
      웹 브라우저에 kibana_server_ip:5601 입력해서 접속
    • 설정
      • 데이터 불러오기
        • Management -> Index Partterns
        • + Create Index Pattern
        • Index pattern 입력 위의 설정대로 따라 했다면 new-api-access-log-YYYY.MM.dd
          error-log-YYYY.MM.dd


          두 가지 형태의 index가 생성되었을 것이다.
          pattern 입력을 한 후 Next step 버튼을 누른다.
        • Time filter field name 설정
      • 원하는 데이터 뽑아 내기
        • Discover -> index 선택
        • 원본 데이터 확인
        • 원하는 데이터만 뽑아서 보기 : 보고 싶은 필드를 확인하고 add를 누르면 해당 필드만 나온다.
        • 선택한 필드 데이터 보기
          미리 설정해 놓은 filebeat에서 추가로 설정한 fields.log_type, fields.server_name와 message만 보이도록 설정했다.
        • 해당 데이터 중 특정 값을 갖는 데이터만 보기

        • 필터링 결과 저장하기
      • 그래프 만들기
        • Visualize -> [+]
        • 원하는 그래프 선택
        • Index 선택
        • 그래프 설정
          error-log 를 서버 별로 필터링해서 막대 그래프로 표현

2018년 5월 14일 월요일

Apache Spark 2.0 개요


목차

  • Apache Hadoop
    • Hadoop 구성
  • Apache Spark
    • Spark란?
    • 데이터구조
    • 클러스터 구성
    • 에코 시스템
    • Apache Zeppelin
  • 설치
    • Apache Spark
    • Apache Zeppelin


Apache Hadoop

●     Hadoop 구성
○     HDFS (Hadoop Distributed File System)
: 파일을 클러스터에 분산해서 저장하고 관리하는 분산 파일 시스템


○     MapReduce
: 대용량 데이터 처리를 분산 병렬 컴퓨팅 환경에서 처리하기 위한 소프트웨어 프레임워크. 함수형 프로그래밍에서 일반적으로 사용되는 Map과 Reduce 함수를 기반으로 주로 구성된다.

○     YARN (Yet Another Resource Negotiator)
: 클러스터의 리소스 관리, 장애 관리 등을 담당하는 프레임워크

Apache Spark

●     Spark란? (2018.04 현재 2.3.0 버전)
○     오픈 소스 클러스터 컴퓨팅 프레임워크
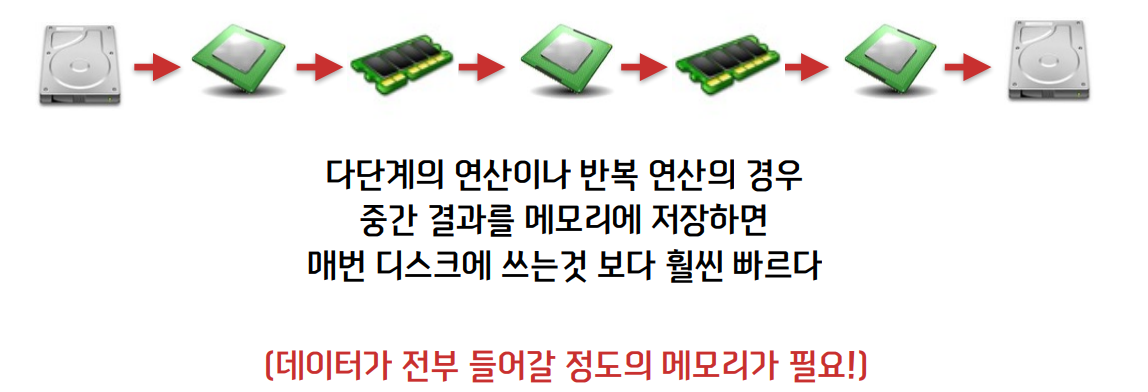
○     Hadoop 보다 100배 가량 빠르다.
■     Hadoop 처리 방식
■     장애복구 (Fault tolerance)를 위해서 비효율적이지만 디스크에 복구지점을 저장하면서 수행한다.
■     Spark 처리 방식
■     장애 복구는 RDD라는 데이터 구조와 DAG (Directed Acyclic Graph)를 이용한 Lineage(계보)를 이용해서 가능하다. 그래도 어쨌든 장애가 발생하면 처음부터 다시 시작해야 되긴하다.
●     데이터 구조
○     RDD (Resilient Distributed Datasets) - Spark 1.0
■     데이터를 가지고 있으며, Scala collection으로 나타냄
■     장애 발생 시 복구 가능
■     Partition이라 불리는 작은 단위로 나눠서 사용 가능
■     Partition을 single machine에서 처리하지 않고, cluster에 분배해서 처리
■     한번 정의하면 변경 불가능. 읽기 전용 데이터 구조
■     RDD 생성 방식
●     데이터 소스로부터 불러옴
●     다른 RDD를 변형해서 새로운 RDD를 만드는 것
■     RDD 연산 : Lazy
●     Transformation : 행위를 기록할 뿐 연산작업이 실제 이루어 지지 않음
○     명령어 : map,  join, filter, sort 등...
●     Action : 모든 작업을 최적화된 경로로 수행 (컴파일러와 비슷)
○     명령어 : count, collect, reduce, save 등...
■     DAG 형태로 Transformation의 Lineage(계보)를 만들고, 중간 과정 데이터는 전부 저장하지 않음
■     장애 발생 시 Lineage를 통해서 처음부터 다시 계산 (게임 비유 -> 세이브 VS 공략집)
○     DataFrame - Spark 1.3
■     명시적인 타입이 지정이 안되어 있는 데이터 구조
■     org.apache.spark.sql.Row 타입의 데이터로 구성된 데이터 셋
■     개념적으로는 RDB의 테이블과 같다.
○     DataSet - Spark 1.6
■     정형 데이터, 반정형 데이터를 처리할 때 사용하는 데이터 구조
■     lambda 함수 사용 가능
■     사용 권장. 성능면에서도 우위에 있다.
○     DataFrame, DataSet 통합 - Spark 2.0    
■     Typed API : DataSet[T]
■     Untyped API : DataFrame = DataSet[Row]
○     비교
■     DataFrame, DataSet 모두 내부적으로는 RDD를 사용한다.


●     클러스터 구성
○     Driver Program
: 프로그램의 Main 함수 (시작점)
■     SparkContext
: 어떻게 클러스터에 접근할 수 있는지 알려주는 객체 (SparkConf 필요)
○     Cluster Manager
: 클러스터에서 필요한 자원을 찾아줌
○     Worker Node
: 실제 작업을 수행하는 노드
■     Executor
: Task를 수행하는 Process
■     Task
: Executor에 할당되는 작업의 단위
■     Job
: 사용자 입장에서의 작업의 단위 (Task의 조합)
●     에코 시스템 : 데이터 분석을 위한 종합 선물 세트
○     분산 저장소 (Distributed Storage)
■     Local FS
■     HDFS (Hadoop Distributed File System)
■     S3
■     CFS (Cassandra File System)
○     클러스터 리소스 매니저 (Cluster Resource Manager)
■     Standalone
■     Hadoop YARN
■     Apache Mesos
○     Spark Core API
■     다양한 언어 지원 : Scala (추천), Python, Java, R
■     쉽고 편리한 인터페이스
○     Spark SQL (SQL Queries) ↔ Apache Hive
○     Spark Streaming (Stream Processing) ↔ Apache Storm
○     MLlib (Machine Learning) ↔ Apache Mahout
○     GraphX (Graph Processing) ↔ Apache Giraph
●     Apache Zeppelin
○     Zeppelin이란?
■     클러스터 구성 없이 간단하게 Spark를 실행할 수 있는 환경
■     Jupyter Notebook과 비슷
■     인터랙티브하게 실행할 수 있다.
■     Spark SQL 실행 결과를 바로 시각화 할 수 있다.

설치

Apache Spark 설치

●     사전 조건
○     Ubuntu 14.X 이상
○     JAVA 1.7 버전 이상 설치, JAVA_HOME 환경변수 등록
●     바이너리 다운로드
○     https://spark.apache.org/downloads.html 에서 원하는 버전 선택해서 다운로드
○     Apache Zeppelin이 지원하는 최신 버전이 2.2.0이므로 그 버전 다운로드
●     압축 해제 (/home/ubuntu 가 홈이라고 가정)
○     tar zxvf spark-2.2.0-bin-hadoop2.7.tgz
●     소프트링크 생성
○     ln -s spark-2.2.0-bin-hadoop2.7 spark
●     환경변수 등록
○     vi ~/.bashrc
아래 내용 추가
export SPARK_HOME=/home/ubuntu/spark
export PATH=$PATH:$SPARK_HOME/bin

Apache Zeppelin 설치

●     바이너리 다운로드
○     http://zeppelin.apache.org/download.html 에서 원하는 버전 선택해서 다운로드
○     잘 모르겠으면 그냥 모든 인터프리터 다 포함되어 있는 버전 다운로드 zeppelin-0.7.3-bin-all.tgz
○     2018.04.25 현재 0.7.3 이 최신 버전이며, Spark 2.2.0을 지원
○     wget http://mirror.navercorp.com/apache/zeppelin/zeppelin-0.7.3/zeppelin-0.7.3-bin-all.tgz
●     압축 해제
○     tar zxvf zeppelin-0.7.3-bin-all.tgz
●     소프트링크 생성
○     ln -s zeppelin-0.7.3-bin-all zeppelin
●     환경변수 등록
○     vi ~/.bashrc
아래 내용 추가
export ZEPPELIN_HOME=/home/ubuntu/zeppelin
export PATH=$PATH:$ZEPPELIN_HOME/bin
●     SPARK_HOME 설정
○     zeppelin 설정 디렉터리로 이동
cd ZEPPELIN_HOME/conf
○     템플릿 파일 복사
cp zeppelin-env.sh.template zeppelin-env.sh
○     템플릿 수정
vi zeppelin-env.sh
○     SPARK_HOME 설정
SPARK_HOME=/home/ubuntu/spark


예제


참고 자료